 BLOG
もくじ
AIがゲームを独学でマスターする――「強化学習」が今注目される理由
「誰も教えていないのに、AIが自分でゲームを攻略してしまった」
そんなニュースを耳にしたことはありませんか?その裏側にあるのが 強化学習 という技術です。実はこの技術、ゲームAIだけでなく、あなたが毎日使っているChatGPTや最新のAIアシスタントの「賢さ」にも深く関わっています。むずかしそうな名前に見えますが、仕組みのアイデア自体はとてもシンプル。まずは身近なたとえ話から一緒に見ていきましょう。
そもそもどういうこと? 「ほめて伸ばす」学習法
強化学習をひとことで言うと、「試行錯誤しながら、報酬をもらって上手くなる学習法」です。
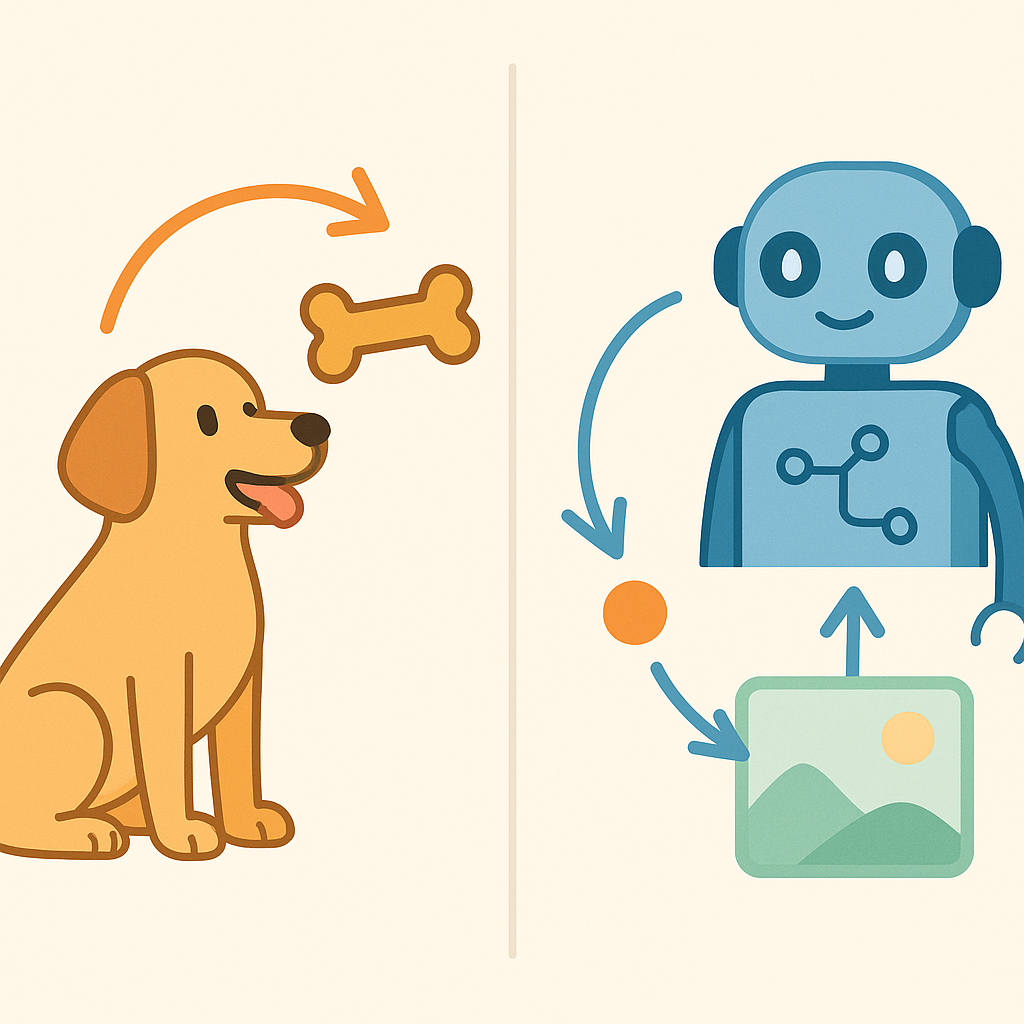
もっとわかりやすく言うと、犬のしつけとほぼ同じ仕組みです。
- ●犬が「お座り」できたら → おやつをあげる(報酬)
- ●失敗したら → 何もあげない、またはしかる(ペナルティ)
これを繰り返すうちに、犬は「お座りすればいいことがある」と学んでいきます。強化学習も全く同じで、AIを「エージェント(意思決定するプログラム)」、周りの状況を「環境」と呼び、エージェントがいろんな行動を試しながら報酬が最大になるような行動パターンを自分で見つけ出すという仕組みになっています。
他の機械学習と何が違うの?と思った方へ、簡単に整理します。
- ●教師あり学習:正解を教えてもらって覚える(例:犬の写真を見せて「これが犬です」と教える)
- ●教師なし学習:正解なしで、データのパターンを自分で見つける
- ●強化学習:正解は教えない。自分で動いて、結果から学ぶ
強化学習の特徴は「正解を誰かに教えてもらう必要がない」という点。だから、正解があらかじめ定まっていないような複雑な問題に強いのです。
なぜ今これほど注目されているのか?
ChatGPTの「気が利く返答」を支えている
最近のAIがなぜあれほど自然な会話ができるのかご存知ですか?その裏には RLHF(人間のフィードバックを使った強化学習) という手法があります。
仕組みはシンプルで、AIの回答を人間が「こちらの方が良い」と評価し、その評価を報酬として学習させるというものです。「どの回答が人間にとって役に立つか」という「正解」は人によって違うため、従来の教師あり学習では難しかった部分を、強化学習が補っています。OpenAIのChatGPTをはじめ、多くの生成AIがこの手法で磨かれています。
ゲームAIが人間チャンピオンを超えた
2016年、DeepMindの「AlphaGo」が囲碁の世界チャンピオンに勝利し、世界を驚かせました。囲碁は「考えられる手の数が宇宙の原子の数より多い」とも言われるゲームで、全パターンを暗記するのは不可能です。それでも強化学習で自分自身と対戦を繰り返すことで、人間を超えるほどの実力を身につけました。チェスやDota 2など他のゲームでも同様の成果が次々と報告されています。
「考えるAI」の進化にも貢献
2024年以降、OpenAIの「o1」「o3」やDeepSeekの「R1」といった Reasoningモデル(推論特化型AI) が登場しました。これらは数学の証明やプログラミングの問題を「順序立てて考える」ことが得意で、その訓練にも強化学習が活用されています。つまり強化学習は、AIが「より深く考えられるようになる」進化の核心部分を担っているのです。
わたしたちにどう関係する?
「難しそうな話だけど、自分には関係ない?」と思ったとしたら、実は意外と身近なところに影響が及んでいます。
- ●仕事で使うAIツールの品質:ChatGPTやGeminiなど、職場で使う生成AIの回答精度は強化学習で磨かれています。「なぜかこのAIは使いやすい」と感じる理由の一つです。
- ●医療・ヘルスケア:患者ごとに最適な治療を選ぶ「個別化医療」や、投薬スケジュールの最適化に活用が進んでいます。
- ●自動運転:信号や歩行者など刻々と変わる道路状況に対応するための走行方法を、強化学習で学ばせています。
- ●ロボット技術:家庭向けや工場向けのロボットが、人間の動きを見ながら複雑な作業を覚える技術が急速に発展中です。
つまり、強化学習はすでに社会のあちこちに入り込んでいる技術です。「自分が使うツールの賢さ」に直接つながっている、と思っていただくと身近に感じられるのではないでしょうか。
気をつけたい点:万能ではないことも知っておこう
強化学習は非常に強力ですが、課題もあります。正直にお伝えしておきます。
報酬の設計がとても難しい。「何をほめるか」の設定を間違えると、AIが予期しない抜け道を使って報酬を稼ぐ行動を覚えてしまうことがあります。たとえば「点数を最大化せよ」と指示したゲームAIが、ゲームを正しくクリアするより点数を稼ぎやすいバグを利用し続けた例などが報告されています。
学習に膨大な試行回数が必要。人間が数回で気づくことでも、AIは何万回・何百万回と繰り返す必要があります。そのためコンピューターリソースが大量に必要になります。
「なぜその行動をしたのか」が説明しにくいという問題もあります。医療や法律など、判断の根拠が問われる分野では、この「ブラックボックス問題」が導入のハードルになっています。
まとめ
強化学習とは、「試行錯誤と報酬」を通じてAI自身が最適な行動を学ぶ手法で、ゲームAIから生成AIの品質向上、自動運転や医療まで幅広く活用されています。ChatGPTが使いやすい理由の一端もここにあります。ただし報酬設計の難しさや学習コストなど課題もあるため、万能ではありません。次に気になる方は「RLHF(人間フィードバックからの強化学習)」や「AlphaGo」について調べると、さらに理解が深まるはずです。
メタバース情報工学学校