 BLOG
もくじ
ChatGPTを3年で10億人が使う時代に――その舞台裏で何が起きているのか
あなたが今日もChatGPTに質問を投げかけるとき、その裏側では世界中の10億人もの人たちが同時にやり取りをしています。1秒あたり約2万9,000件ものメッセージが飛び交う、まさに前代未聞の規模です。これほどのアクセスを支えるには、普通のシステムではとても追いつきません。OpenAIが公式エンジニアリングブログで明かした「Habitat(ハビタット)」というストレージ基盤の話は、AI技術の裏側を知るうえで非常に示唆に富んでいます。技術者でなくても、「なぜChatGPTはあれだけ速く答えられるのか」「その仕組みはどうやって作られたのか」を知ると、AIとの付き合い方が少し変わるかもしれません。
そもそもどういうこと?
ChatGPTは2022年末にリリースされ、2026年6月には 月間アクティブユーザーが10億人を突破 したと報告されています(Sensor Towerのデータ、Reutersが報道)。Google MapsやInstagramが同じ規模に達するまで5〜8年かかったのに対し、ChatGPTはわずか約3年。史上最速の記録です。
これだけの人数が使うサービスを支えるには、膨大な「記憶」と「処理速度」が必要です。たとえば、あなたがChatGPTと会話するとき、過去のやり取りの履歴・アカウント情報・GPTsの設定など、さまざまなデータをリアルタイムで読み書きしています。これを支えているのが、OpenAI独自のオンラインストレージプラットフォーム「Habitat(ハビタット)」です。
「オンラインストレージ」というと、GoogleドライブやDropboxのようなファイル保存サービスを思い浮かべるかもしれません。でも、ここでいう「オンライン」は少し意味が違います。スマホの電話帳に例えるなら、「クラウドに預けてある写真(コールドストレージ)」ではなく、「今まさに画面に表示されている連絡先(オンラインストレージ)」。つまり、すべてのデータが常時、低遅延で読み書きできる状態に置かれているということです。
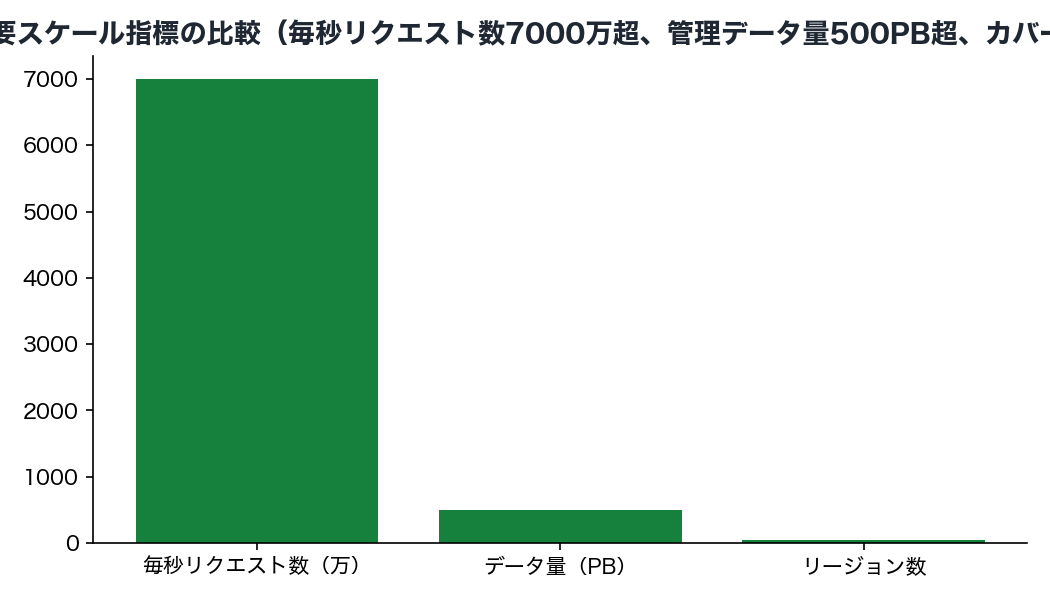
現在、Habitatは世界約40の地域(リージョン)に展開され、毎秒7,000万件以上のリクエストを処理し、500ペタバイト超のデータを管理しています。500ペタバイトとは、1テラバイトのHDDが50万台分に相当する容量です。
なぜ注目されているのか / 何がすごいのか
史上最速の成長に「その場で」対応した
Habitatは2023年のDevDay(OpenAIの開発者向けイベント)で、GPTs(カスタムAIアシスタント)を支えるためのシンプルなPythonのライブラリとして生まれました。数行のコードで使えるような、小さな部品です。それが約3年で、年間10倍超のペースで成長し、500PBを扱う複雑な分散システムへと進化しました。
多くのシステムは「将来のスケールを見込んで設計する」ものですが、Habitatの場合は 意図的に「今必要な機能だけを素早く作る」戦略を選択 しています。これを技術の世界では「技術的負債を引き受ける」と言います。借金のように、後で返済(=書き直し)する前提で、まず速く動くものを作るという考え方です。
「テールレイテンシ」という見えにくい敵との戦い
技術的な課題の中でも特に重要だったのが「テールレイテンシ(tail latency)」の問題です。難しい言葉ですが、こんなイメージです。
コンビニのレジを想像してください。普通のお客さんは30秒で会計が終わりますが、たまに10点以上の商品をバラバラに袋詰めするお客さんが来て、後ろに長い列ができてしまう。その「ごくたまに起きる最悪のケース」がテールレイテンシです。
ChatGPTへの1回の質問が、裏側で数百回ものデータ読み取りを引き起こすことがあります。その数百回のうち1回でも極端に遅くなると、ユーザーへの返答全体が遅れます。Habitatの初期実装ではPython(プログラミング言語)の仕組みの都合上、高負荷時に数百ミリ秒〜数秒の遅延が発生することがあり、これがユーザー体験を直撃していました。
AIが「自分自身のインフラ」を書き直した
この問題を根本から解決するため、OpenAIは2026年第2四半期にHabitatをPythonからRust(ラスト)という別のプログラミング言語に書き直しました。Rustはメモリ管理が非常に効率的で、大規模・高負荷なシステムに向いている言語です。
ここで驚くべき事実があります。この大規模な書き直しを担当したのは、わずか2名のエンジニアです。しかも彼らは自社製AIコーディングエージェント「Codex」と「GPT-5.5」を活用してこの移行を完遂しました。結果として、CPU(処理装置)の効率は6倍、メモリ(作業用の記憶)の効率は15倍に改善されています。
「AIがAI自身のインフラを書き直した」 というこの事実は、単なる技術的な成功談にとどまりません。AIツールを使えば、小規模なチームが従来なら何十人もかかるような大仕事を成し遂げられるという、新時代の開発スタイルを体現しています。
わたしたちにどう関係する?
「大規模インフラの話なんて、自分には関係ない」と思うかもしれませんが、実はいくつかの点で私たちの仕事や学びに直接つながります。
① ChatGPTの「速さ」と「安定性」は今後も改善される
Rust移行により処理効率が大幅に上がったことで、ChatGPTはより多くのユーザーをより速くさばけるようになります。特に日本のような特定の時間帯に集中してアクセスが増える地域では、応答速度の改善として実感しやすいはずです。
② 「AIエージェントで開発する」という働き方のリアルな先例
2名のエンジニアがAIを使って大規模システムをリライトしたという事実は、フリーランスのエンジニアや小規模チームにとっても「AI活用で少人数でも大仕事ができる時代」を示す具体例です。プログラミング学習者にとっては、「AIツールとの協働スキル」が今後の武器になることを教えてくれます。
③ 「技術的負債を意図的に引き受ける」発想はビジネス全般に応用できる
最初から完璧なシステムを目指すのではなく、まず動くものを作って速くユーザーに届け、後から改善する。この考え方は、新しいサービスや社内ツールを作るときにも参考になります。「完成度より速度」を意識した意思決定は、ChatGPTの成功を支えた哲学のひとつ です。
気をつけたい点
「10億人」という数字は推計値
「10億ユーザー」という数字は、Sensor Towerによる月間アクティブユーザーの推計値であり、OpenAI自身が公式に発表した数字ではありません。OpenAIは通常「週間アクティブユーザー」を指標として使っており、同時期の週間ユーザーは約9億人とされています。数字のインパクトに引きずられず、「前代未聞の規模に急速に達した」という事実の大枠を捉えるのが正確です。
「奇跡の運用」への厳しい見方もある
外部の技術者からは「単一ライタ構成のPostgreSQLクラスターをこの規模で維持できたのは驚異的だが、カスタムのAzure機能や常時対応のエンジニアリングで辛うじて成立しているパッチワークだ」という批評も出ています(SurrealDBによる分析)。OpenAIのインフラが特殊なMicrosoftとの提携関係に支えられている部分もあり、誰でも再現できる汎用モデルとは言い切れません。
記事はまだ「Part 1」
OpenAIのエンジニアリングブログはこの内容が2部構成の第1弾です。データベース層(実際にデータをどう保存しているか)の詳細はPart 2で公開予定とされています。現時点では全体像の半分しか明かされていない点に注意が必要です。
まとめ
ChatGPTを3年で10億人規模に育てた裏側には、「まず速く動くものを作り、AIを使って書き直す」という大胆な開発戦略がありました。Habitatの進化は、技術的な成功談であると同時に、 小さなチームがAIと協働すれば大きなことを成し遂げられる という新時代の働き方の先例でもあります。次のステップとして、OpenAIのPart 2ブログやRustという言語に興味を持ってみると、AIインフラの全体像がさらに深く見えてくるはずです。
参考文献
メタバース情報工学学校