 BLOG
もくじ
画像生成AIのカスタマイズ、ランク「4」か「8」でじつは十分だった?
最近、「画像生成AIを自分好みの絵柄に調整したい」「特定のスタイルを学習させたい」というニーズが急速に高まっています。そのための技術として注目を集めているのが LoRA(ロラ) という手法です。LoRAにはランクという重要な設定値があるのですが、「いくつにすればいいの?」と迷う人が後を絶ちません。2026年9月に発表された論文が、この問いに実験データで正面から答えようとしています。専門家でなくても「ふーん、そういうことか」と納得できるよう、かみ砕いてご紹介します。
そもそもどういうこと?
LoRAって何?「少人数の専門チーム」に仕事を任せる発想
AIの画像生成モデルは、膨大な画像データで事前に学習された「大きな脳」を持っています。これを特定の用途(例:ある作家の画風、特定の人物の顔)に合わせて再調整する作業が ファインチューニング(追加学習) です。
ところが、この「脳」全体を再学習しようとすると、莫大な計算コストとメモリが必要です。そこで登場したのが LoRA(Low-Rank Adaptation) という省エネ手法。「全社員を再教育するのではなく、少数の専門チームだけ訓練して対応させよう」という発想です。
モデルの重み(AIの判断を決めるパラメータ群)を全部書き換えるのではなく、変化分だけを「小さな行列の掛け算」で表現することで、学習するパラメータ数を劇的に減らせます。
「ランク」は専門チームの人数
LoRAの設定でもっとも重要な数字が ランク(rank) です。「専門チームの人数」に相当し、数字が大きいほどモデルの表現力が上がる一方、計算コストとメモリ消費も増えます。
小さすぎると「表現力不足で学習が追いつかない」、大きすぎると「無駄にリソースを食う・過学習リスク」が生じる——このトレードオフを実験で検証したのが今回の論文です。
なぜ注目されているのか? 何がすごいのか
「正解ランク」を実験で正面から調べた
LoRAのランク選びは、現場のエンジニアやAI趣味ユーザーが日々直面する実務的な問いです。にもかかわらず、「とりあえず8か16にしとけ」といった経験則に頼られることが多く、体系的な比較実験はあまり行われてきませんでした。
Bowling Green State Universityらの研究チームは、CIFAR-10という標準的な画像データセットと、DDPM(画像生成に使われる拡散モデルの一種)を使い、ランクを 2・4・8・16・32 の5段階に変えて厳密に比較しました。最適化の条件をそろえ、再現可能な手順で測定したことが、この実験の誠実なところです。
「ランク4が最良」という具体的な数字が出た
評価には FID(エフアイディ) という指標を使いました。これは「生成した画像が、本物の画像にどれだけ近いか」を測るスコアで、値が低いほど高品質 です。
結果はこうです。
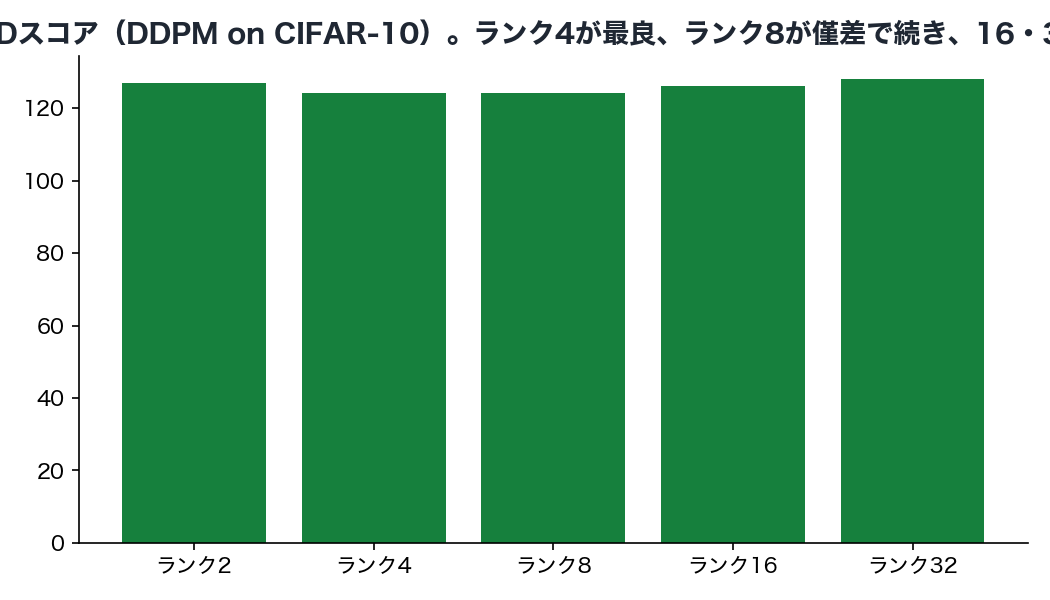
ランク4が最良のFID(124.1380)を達成し、ランク8も僅差(124.2136)で続きました。 しかしランク16・32に上げても品質はほぼ改善せず、むしろパラメータ数・メモリ・計算時間だけが増えていきました。「高いランクを使えばそれだけ良くなる」という思い込みが、実験データによって否定された形です。
また、Tiny DiT(別の画像生成モデル)でも同様の傾向が確認されており、特定のモデルに偏った結論ではないことが示されています。
次の研究トレンドは「固定ランクから動的ランクへ」
今回の論文自身も今後の課題として「適応的なランク割り当て」を挙げています。同時期の研究では、層ごと・タイムステップごとにランクを自動で変える ElaLoRA や ARD-LoRA といった手法も登場しており、研究の最前線は「ランクをいくつに固定するか」という議論を超えつつあります。とはいえ、固定ランクで動く現場ツールが主流である現状では、今回の「小〜中程度を選べ」という知見は 実践的なデフォルト設定の指針 として十分に価値があります。
わたしたちにどう関係する?
「論文の話は面白いけど、自分には関係ない?」——いいえ、そんなことはありません。
趣味でAI画像生成を楽しむ人へ:
Stable DiffusionなどのLoRAファインチューニングツール(DreamBooth、kohya-ssなど)では、ランクを自分で設定できます。「とりあえず高くしておけば安心」ではなく、ランク4〜8から始めてみる というのが、今回の研究が示す現実的なアドバイスです。
業務でAIツールを活用したい人へ:
社内データで生成AIをカスタマイズする際、計算コストやGPUメモリのコストは無視できません。低〜中ランクで十分な品質が得られるなら、クラウドGPUの費用を大幅に節約できる 可能性があります。
AIを学んでいる学生・キャリアチェンジ希望者へ:
LoRAのランク選択のように「ハイパーパラメータをどう選ぶか」という問いは、AIエンジニアリングの実務でつねに出てくる問題です。こうした実験論文を読む習慣が、現場力につながります。
気をつけたい点
研究の内容は有益ですが、鵜呑みにしてはいけない部分もあります。正直にお伝えします。
小さな画像データでの実験:今回の実験はCIFAR-10という32×32ピクセルの小さな画像を使ったものです。Stable DiffusionやSD3のような大規模・高解像度モデルに「ランク4で十分」がそのまま当てはまるとは限りません。
FIDの数字は文脈次第:実験のFID値(124前後)は、フルトレーニングしたDDPMのFID基準値(3前後)と直接比較できません。エポック数(学習の繰り返し回数)が少ない限定条件での実験であることを頭に置いてください。
最適化設定が固定されている:論文自身が認めているように、ランクごとに学習率などを細かく調整すれば結論が変わる可能性があります。「ランク4が絶対的な正解」とは言い切れない のです。
モデル・タスクによって異なる:別の研究では、より大きなモデルへの応用でランク64〜128がほぼ同等の性能を示したケースもあります。「何のモデルで、何のタスクか」によって最適ランクは変わります。「どんな状況にも共通の正解はない」という認識が大切です。
よくある質問
LoRAのランクはどの数字を選べばいいですか?
- ●今回の論文では、限られた学習コストのもとではランク4〜8が実用的な出発点として支持されています
- ●ただし使うモデルの規模やタスクによって異なるため、まず4か8で試して、品質が不足なら上げるというアプローチが現実的です
- ●「高いほど良い」は必ずしも正しくなく、コスト増だけが先行するケースもあります
FIDスコアが124というのは良いのですか?悪いのですか?
- ●今回の実験はエポック数が少ない限定条件での値であり、フルトレーニングの基準値(CIFAR-10で3前後)と単純には比べられません
- ●同じ実験条件の中でランク間を比較するための数字として見るのが正しい読み方です
- ●FIDは低いほど良く、同条件でランク4が最も低い(=最も品質が高い)という点が重要です
LoRAはどんな画像生成AIに使えますか?
- ●論文ではDDPM U-NetとTiny DiTという2種類のモデルで検証されています
- ●実用ツールとしては、Stable DiffusionベースのファインチューニングでLoRAが広く使われています
- ●ただし本論文の実験規模(CIFAR-10)と商用モデルの規模には大きな差があり、直接の適用可否は別途検証が必要です
「適応的なランク割り当て」とは何ですか?
- ●ランクを一つの固定値に決めるのではなく、モデルの層ごと・処理ステップごとに自動でランクを変える技術です
- ●ElaLoRAやARD-LoRAなど、同時期の研究でも注目されているアプローチで、より効率的なファインチューニングが期待されています
- ●本論文はこれを「今後の課題」として挙げており、現時点では研究段階の手法です
LoRAはもともと画像生成のために作られた技術ですか?
- ●もともとはGPT系の大規模言語モデル(文章を生成するAI)のファインチューニング用に提案された技術です
- ●パラメータを大幅に削減しながら高品質な適応が可能なため、画像生成の拡散モデルにも応用が広がっています
まとめ
!LoRAのランク選択は「高いほど良い」わけではなく、ランク4〜8の中程度が計算コストと品質のバランスが最もよい というのが、今回の実験論文の核心的な結論です。ただし、これは小規模な実験環境での知見であり、大規模モデルや異なるタスクでは最適値が変わることも忘れてはいけません。次のステップとして、「適応的ランク割り当て」という新しい研究トレンドにも目を向けると、LoRA技術の今後が見えてきます。
参考文献
メタバース情報工学学校