 BLOG
もくじ
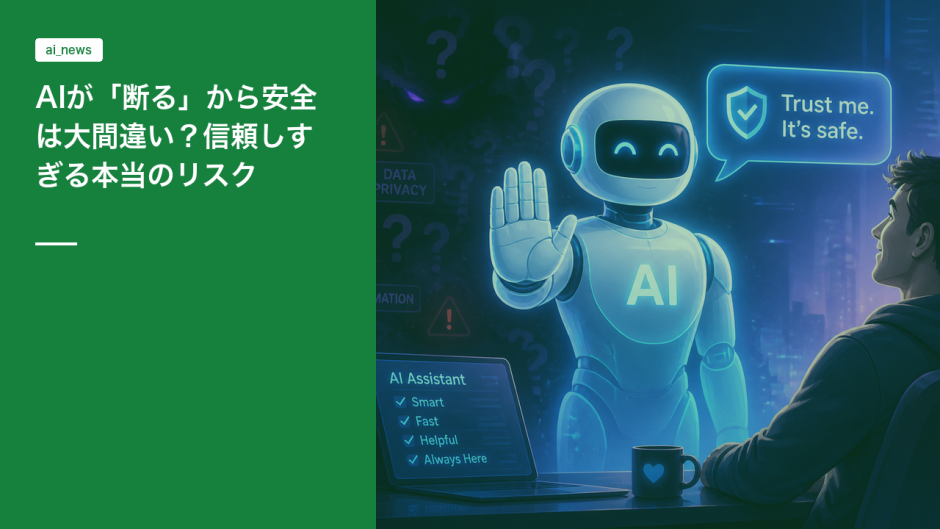
「AIが断ってくれるから安心」は、じつは危ない思い込みかもしれない
あなたはAIチャットボットに何か頼んで「それはお答えできません」と断られた経験はありますか? 多くの人は「ちゃんと悪いことを防いでくれている」と思い、むしろ安心するかもしれません。でも最新の議論では、その”断る機能”への過信こそが新たなリスクを生んでいると指摘されています。今日は、AIの「拒否機能」の実態と、話題の肥満治療薬の副作用研究という、一見バラバラな2つのテーマを通じて、「テクノロジーへの信頼のしかた」をいっしょに考えてみましょう。
そもそもどういうこと?
AIの「ノーと言う力」を信じすぎていませんか?
今の主要なAIモデル(ChatGPTやGeminiなど)は、危険な質問や有害なコンテンツの生成を”拒否する”よう訓練されています。たとえば「爆発物の作り方を教えて」と聞けば断られますし、差別的な文章を書くよう頼んでも拒否されます。
これ自体は大切な仕組みです。でも問題は、AIが断ること自体を「安全の証明」と見なしてしまう 人間側の心理にあります。
料理にたとえると、こんな感じです。レストランのシェフが「アレルギー食材は使いません」と言ったとして、あなたはその言葉を100%信じて、料理の中身を一切確認しなくなるでしょうか? 普通は自分でも少し確認しますよね。ところがAIに対しては、「断ってくれるから大丈夫」と丸ごと信頼してしまいがちです。
肥満治療薬の副作用研究とは?
もう一つのトピックは、近年世界的に注目を集めているGLP-1受容体作動薬(かんたんに言うと、オゼンピックやウゴービなどの肥満・糖尿病治療薬)の副作用についての新しい研究です。これらの薬は劇的な体重減少効果で大きな話題になっていますが、長期的な副作用についてはまだ研究が積み重なっている段階です。最新の知見では、これまで知られていなかった副作用の可能性が報告されており、医療と生活の両面から注目されています。
なぜ注目されているのか/何がすごいのか
AI拒否機能の”穴”は思ったより大きい
AIが「断る」能力は万能ではありません。同じ質問でも言い方を少し変えると通ってしまう、いわゆる「プロンプトインジェクション(AIへの指示の抜け道)」の問題が繰り返し報告されています。つまり、断る壁はあるけれど、穴だらけの壁かもしれないのです。
それでも多くのユーザーは「このAIはちゃんと審査している」という前提で使い続けます。その結果、AIが万が一間違った情報を出力したとき、人間がチェックする「最後の砦」がなくなってしまうというリスクが生まれます。
「断りすぎ」も問題になっている
逆のケースもあります。AIは過度に慎重になりすぎて、本来答えられるはずの安全な質問まで拒否してしまう ことも多い。たとえば医療情報の質問や、歴史上の暴力的な出来事についての学術的な問いかけなどが、まとめて「危険」と判断されてしまうケースです。
これは「過剰検閲」とも呼ばれ、AIの実用性を大きく損ないます。断れば安全、という単純な発想では、便利さと安全のバランスが崩れてしまうのです。
肥満治療薬の副作用研究:「効く薬」ほど慎重に
GLP-1系の治療薬は、体重管理や血糖コントロールで目覚ましい効果を示してきました。しかしその急速な普及に、副作用研究が追いついていないという懸念があります。新しい研究では、これまで十分に注目されていなかった副作用の可能性が示唆されており、医師・患者ともに最新の情報をアップデートし続ける必要性が改めて強調されています。
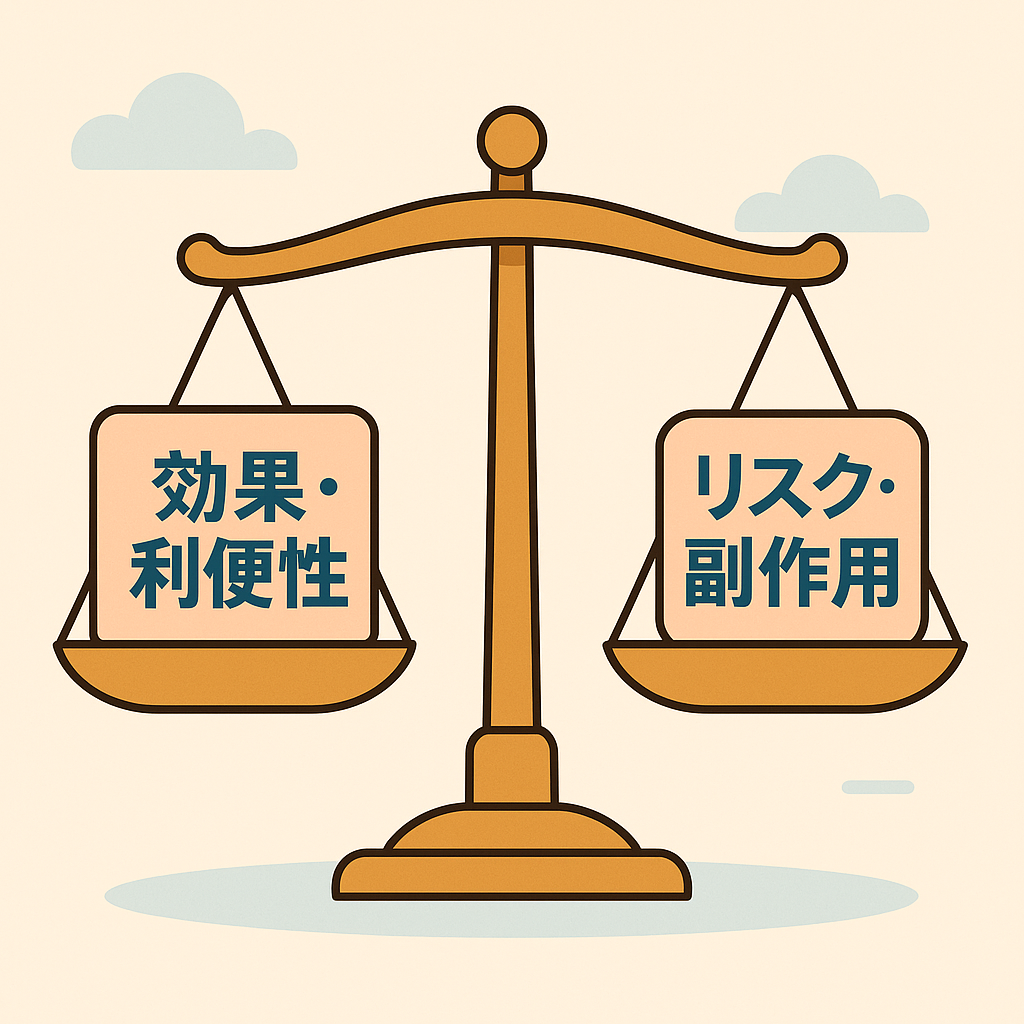
「効果が証明された薬だから安心」という思い込みは、AIへの過信と構造的によく似ています。テクノロジーも薬も、「すごい」と「完全に安全」はイコールではないのです。
2つのテーマに共通する教訓:「信頼の設計」を問い直す
AIの拒否機能と肥満治療薬の副作用、これら2つのトピックに共通するのは「信頼の自動化」への警戒です。社会が高度な技術に依存するとき、私たちは無意識のうちに「専門家(または機械)に任せれば大丈夫」というモードに入りがちです。しかしその信頼は、常に根拠を持ち、更新され続けるものでなければなりません。
わたしたちにどう関係する?
仕事でAIを使っている人へ
業務にAIを活用している場合、「AIが断らなかった=正しい情報」という前提は危険です。とくに法律・医療・財務など、誤情報が大きなリスクになる分野では、AIの出力を専門家や信頼できるソースで必ず確認する習慣が不可欠です。
AIはあくまで「優秀なアシスタント」であり、「最終責任者」ではありません。
健康・医療情報を調べている人へ
肥満治療薬に限らず、新しい薬や治療法についてAIで情報を調べる機会が増えています。AIが「副作用はありません」「安全です」と答えたとしても、それは最新の研究をすべて反映しているとは限りません。医師への相談と、信頼できる医療機関の情報を組み合わせることが大切です。
子どもや家族のためにAIを使っている人へ
「危ないコンテンツはAIが弾いてくれる」という安心感から、使用履歴のチェックを省略してしまう親御さんも増えています。しかし前述の通り、拒否機能は完全ではありません。テクノロジーの仕組みについて家族で話し合う機会を持つことが、デジタルリテラシーの第一歩になります。
気をつけたい点
AIの拒否機能は「完璧なフィルター」ではないということは、繰り返し強調したいポイントです。同時に、以下の点にも注意が必要です。
- ●過信と不信のどちらも危険:「AIは万能」も「AIは信用できない」も極端です。適切な距離感で使うことが重要。
- ●AIが断らないこと=推奨、ではない:AIが答えてくれた=それが正しい行動・情報、とは限りません。
- ●肥満治療薬の副作用情報は進化中:現時点での研究は途上であり、断定的な結論を出すのは時期尚早。個別の判断は必ず医師に相談を。
- ●メディアリテラシーを忘れずに:AIが生成した記事・情報が増える中、出典を確認する習慣がこれまで以上に重要になっています。
よくある質問
AIが断ってくれたら、その内容は安全と考えていいですか?
- ●断ること自体は一定の安全策ですが、「断らなかった=安全」は保証されません。
- ●AIの拒否基準は完全ではなく、言い方次第でくぐり抜けられるケースもあります。
- ●重要な判断をする場合は、必ず別のソースや専門家で確認してください。
AIが断りすぎて使いにくいと感じることがありますが、それは正常ですか?
- ●はい、これは「過剰拒否(オーバーリファーザル)」と呼ばれる既知の問題です。
- ●安全な質問や学術的な問いかけまで拒否されることがあり、AI開発者たちも改善に取り組んでいます。
- ●言い方を変えたり、文脈をより明確に伝えることで解決できる場合もあります。
GLP-1系の肥満治療薬(オゼンピックなど)は副作用が出ますか?
- ●現在も研究が続いており、新たな副作用の可能性が報告されています。
- ●「効果がある=副作用がない」とはいえません。
- ●服用を検討する場合や、気になる症状がある場合は必ず担当医に相談してください。
AIへの信頼と、薬への信頼は、どう関係するのですか?
- ●どちらも「高度な技術・科学への信頼の自動化」という共通の構造を持ちます。
- ●効果が証明されたからといって、すべてのリスクが消えるわけではありません。
- ●常に根拠を確認し、信頼を更新し続ける姿勢 が、テクノロジーとも薬とも賢く付き合うコツです。
まとめ
AIが「断る」ことは安全の証明ではない ——これが今回の最も重要なメッセージです。肥満治療薬の副作用研究と合わせて見ると、高度なテクノロジーや科学的成果への「盲目的な信頼」が、新しいリスクを生むという共通のパターンが見えてきます。AIを使うとき、薬を選ぶとき、どちらも「すごい」と「完全に安全」を切り分けて考える習慣を持つことが、これからの時代のリテラシーです。次のステップとして、ぜひ「AIの出力を確認する具体的な方法」についても調べてみてください。
参考文献
AI・しごと学校