 BLOG
もくじ
「AIはいつも文章を書く」は、もう古い? 高速判断に特化した新型AI「Jev」の登場
チャットAIがこれだけ普及した今でも、「AIを業務システムに組み込もうとすると、思ったより遅くてコストがかかる」という声は絶えません。その根本的な原因に正面から向き合ったのが、AIスタートアップ・TypeSafeの新モデル 「Jev(ジェフ)」 です。2026年9月に発表されたこのモデル、従来のAIとは根本的にアーキテクチャが異なり、「テキストをまったく生成しないAI」 という異色の存在として注目を集めています。
そもそもどういうこと?
AIに「文章を書かせる」ことの非効率さ
ChatGPTに代表される大規模言語モデル(LLM)は、もともと 「人間が読むための文章を生成する」 ことを目的に作られています。でも実際のビジネス現場で求められるのは、「このメールはクレームか問い合わせか?」「このスコアは高・中・低のどれ?」といった シンプルな判断 だったりしませんか?
そこでよくある解決策が、「LLMに選択肢を渡してどれか答えさせ、その文字列をプログラムで読み取る」という方法です。でもこれ、実はずいぶん遠回りです。まるで「ファストフードの注文をするのに、シェフに詩を書いてもらってからメニューを読み取る」ようなもの。余分なプロセスが多く、遅くて、コストもかかります。
Jevが取ったアプローチ:「判断だけ返す」
TypeSafeが出した答えは、文章生成を捨てることでした。
Jevが返せる答えは3種類に絞られています。
- ●Choice(選択):あらかじめ決めた選択肢から一つを選ぶ
- ●Score(スコア):定義したスケールで評価値を返す
- ●Null(有無):yes/noの確率を返す
これを 「System One Model(システムワン・モデル)」 と同社は呼んでいます。名前の由来は、ノーベル賞経済学者ダニエル・カーネマンの著書『ファスト&スロー』に登場する「System 1(速くて直感的な判断)」と「System 2(遅くて論理的な思考)」の区別から来ています。Jevは前者、つまり「素早い判断」の専門家として設計されているわけです。
なぜ注目されているのか / 何がすごいのか
速さとコストが桁違い
Jevのレイテンシ(応答にかかる時間)は 70〜500ミリ秒 。一方、主要なLLMは3秒〜329秒かかります。TypeSafeの発表によれば、 最大200倍の速度差 があるとのこと。
コストの差はさらに大きく、入力コストは100万トークンあたり 0.042ドル 。比較としてAnthropicのClaude Fable 5.1は10ドルなので、約238倍の差があります。さらに出力コストは 無料 です。
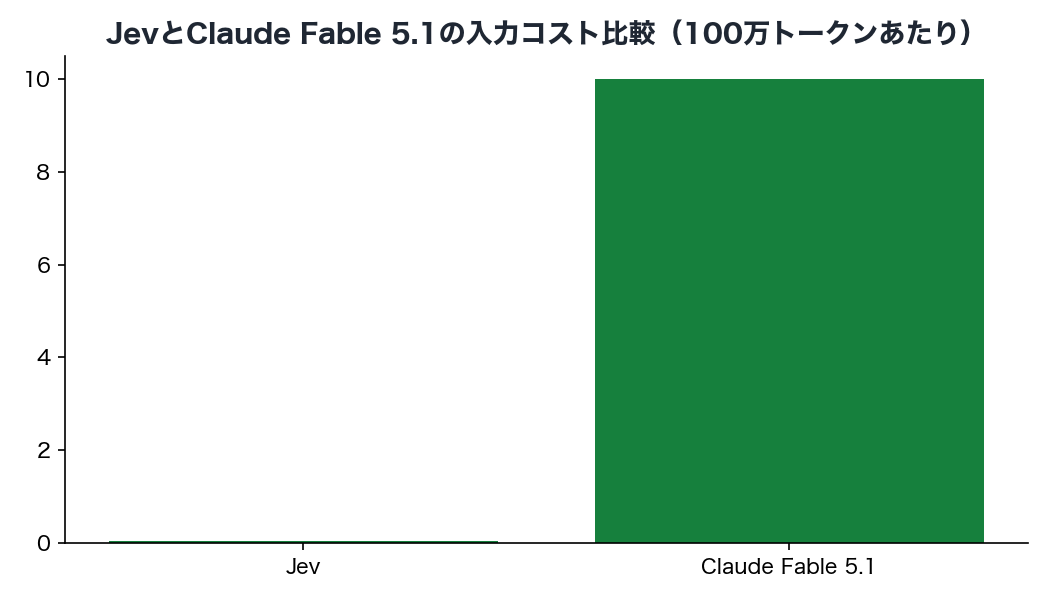
もちろん、TypeSafe自身も「ホームページの数値(193.6倍・444.6倍の改善)は実世界での結果の上限付近」「長期的な価格の持続可能性は未証明」と正直に認めています。それを差し引いても、オーダー(桁)レベルの差があることは確かです。
「ハルシネーション(幻覚)しない」の本当の意味
よく「このAIはハルシネーションしない」という主張を目にしますが、Jevの場合はその理由が明確です。
Jevは そもそもフリーテキストを生成しない ので、「ありもしない事実をもっともらしく書き連ねる」という従来型のハルシネーションが構造的に起きません。出力できる答えは最初から決まった形式に限られているからです。
ただし正確に理解しておきたい点があります。これは「選択肢の中から誤った答えを選ばない」という意味ではありません。型(かた)の安全性は保証されますが、判断の正確さそのものは別問題 です(詳しくは「気をつけたい点」で後述)。
「キャリブレーション」という新しい信頼性の尺度
Jevの訓練手法は 「RLCD(Reinforcement Learning for Calibrated Decisions)」 という独自の方式です。
少し噛み砕きましょう。AIが「70%の確信でAだと思う」と答えたとき、実際に約70%の確率でAが正しければ、そのAIは 「キャリブレーションされている(較正されている)」 といいます。天気予報で「降水確率70%」と言ったら本当に7割くらい雨が降る、あの感覚に近いです。
これに対して、多くのLLMは「自信満々に言ったけど間違い」「正しいのに自信なさそう」という状況が起きやすい。Jevはこのキャリブレーション精度を最優先に訓練することで、「確率を信じてルーティングできるAI」 を目指しています。「信頼度が60%以下ならベテランスタッフへエスカレーション」という自動化ルールを組みやすいのはこのためです。
創業者の経歴が示す本気度
TypeSafe CEOのDiogo Almeida氏は、OpenAIの元研究者であり、ChatGPTの共同発明者でもある人物 です。「AIはチャットだけではない」という信念のもと、2年間のステルス(非公開)期間を経て今回のリリースに至っています。そのバックグラウンドが、このアプローチへの真剣さを裏付けています。
わたしたちにどう関係する?
Jevが実際に想定しているユースケース(使われ方)は、意外と身近です。
- ●カスタマーサービスの仕分け:届いた問い合わせを「クレーム/注文確認/解約希望」などに素早く振り分ける
- ●請求書処理:書類をスキャンして「承認可能/要確認/却下」に分類する
- ●AIエージェントの監視:AIが自動で処理した内容を「問題なし/要チェック」でスクリーニングする
- ●セキュリティアラートの優先度付け:大量のアラートを重要度でスコアリングする
ポイントは「 Jevを最初の判断ゲートとして使い、難しいケースだけ高性能LLMに回す 」という組み合わせです。全件をGPT-6 Astraのような高度なモデルで処理するのではなく、80〜90%はJevが高速・低コストに仕分けし、残りだけ大きなモデルにお願いする、という設計です。コストを一桁以上削りながら、質を落とさない可能性があります。
エンジニアでない方にとっても、「AI導入がこれだけ安くなるなら、うちの部署でも使えるかも」という話になってきます。AIによる業務自動化の裾野が、今後大きく広がりそうです。
気をつけたい点
正直に限界も整理しておきます。
① ベンチマークはまだ自社評価のみ
精度比較(67.8%)は、TypeSafeが選んだ4つのワークフローで、正解ラベルではなくGPT-6 AstraとFable 5.1の出力平均と比較したものです。独立した第三者機関によるベンチマーク検証はまだありません。
② 「選択肢を固定する」ことの落とし穴
Jevは選択肢をあらかじめ決めなければなりません。そのためテストでは、「実際の答えがどの選択肢にも当てはまらない」場面で、誤った選択肢を自信を持って選んでしまう事例が確認されています。
③ 使えない用途も多い
文章の生成・書き直し、文字起こしの要約、厳密な計算、画像を含む処理にはJevは適しません。また、すでに決定論的なif文(「金額が10万円以上なら審査へ」など)で解決できることなら、コストゼロのコードの方が優秀です。
④ アーキテクチャの詳細は非公開
モデルの規模や学習データ、実際の内部構造については公開されておらず、外部からの独立した評価ができない状態です。
よくある質問
ChatGPTやClaudeとJevはどう違うの?
- ●ChatGPTやClaudeは「人間が読む文章」を生成するAI。Jevは文章を一切生成せず、「Choice・Score・Null」の3形式だけで判断を返す
- ●用途がまったく異なるため「どちらが優れているか」という比較にはならない。Jevはあくまで分類・スコアリング・振り分けの専門家
「ハルシネーションしない」は本当に信頼できる?
- ●選択肢の形式通りに答えることは保証される(型エラーは起きない)
- ●ただし、渡した選択肢の中から誤ったものを選ぶ可能性はある
- ●「文章として事実を捏造する」タイプのハルシネーションは構造上起きないが、判断の正確さは別途評価が必要
コストが安すぎて品質が心配なのですが…
- ●現在の価格設定の長期的な持続可能性はTypeSafe自身も未証明と述べている
- ●精度は自社ベンチマークで67.8%(GPT-5.6 Terraと同水準)。高性能モデル(Opus 5は73.1%)より低い
- ●用途によっては「速くて安い7割精度」で十分なケースも多く、コスト・精度のトレードオフを設計段階で判断する必要がある
「System One Model」って、今後の業界スタンダードになる?
- ●TypeSafeが提唱した新しいカテゴリ名であり、現時点では同社独自の概念
- ●ただしコミュニティの見方では「GPTの代替」ではなく「構造化された選択のための安価でキャリブレーション済みの推論エンジン」として評価されており、新カテゴリとして定着するかは今後の第三者評価次第
「Jev」という名前に意味はある?
- ●Jevons paradox(ジェボンズのパラドックス)へのオマージュとされている
- ●これは「資源の効率が上がると、むしろ使用量が増える」という経済学の考え方
- ●AI処理コストが大幅に下がれば、AI活用の総量が爆発的に増えるという逆説を含意している
まとめ
TypeSafeの「Jev」は、「AIはテキストを生成するもの」という前提を崩し、 「判断を返す専用モデル」 という新しいカテゴリを実用レベルで提示した点が最大の革新です。速度・コストの圧倒的な差と、確率のキャリブレーション設計は、AIを業務フローに組み込む際の「判断ゲートウェイ」として有力な選択肢になりえます。一方で、ベンチマークは自社評価のみ・適用範囲の限界・価格の持続性など、まだ未検証の部分も多く残ります。今後の独立した評価と実導入事例が揃ってきたとき、このアーキテクチャの本当の価値が見えてくるでしょう。引き続き「AIエージェント設計」や「LLMとの組み合わせ方」についても、当ブログで取り上げていきます。
メタバース情報工学学校